카프카의 탄생배경
카프카는 2010년경 LinkedIn에서 만들어졌습니다. 개발자는 Jay Kreps, Neha Narkhede, Jun Rao 등이고, 2011년 오픈소스로 공개되어 Apache 프로젝트가 되었습니다.
탄생이 된 배경은 서비스가 커지며 시스템 간 데이터 전달이 엉망이 되었습니다.
- 로그, 사용자활동, 메트릭 등을 여러 시스템(DB, 검색, 분석, 모니터링 등) 이 서로 1:1로 직접 연결해서 주고 받았습니다.
- 시스템이 늘수록 연결이 기하급수적으로 늘어나 "스파게티 구조"가 됐고, 관리와 장애 대응이 매우 어려웠습니다.
- 기존 메시징 시스템(ActiveMQ 등)은 LinkedIn 규모의 대용량실시간 처리를 감당하기 어려웠고, 배치 방식은 너무 느렸습니다.
이에 해결방안은 모든 데이터를 한 곳으로 모으는 중앙 데이터 파이프라인을 만들자는 발상 이였습니다.
- 데이터를 보내는 쪽(프로듀서)과 받는 쪽(컨슈머)를 분리해서, 서로를 몰라도 되게 함
- 메시지를 디스크에 로그 형태로 순차 저장해 높은 처리량과 재처리를 가능하게 함
- 파티션으로 분산해 수평 확장이 가능하게 함
메시지 큐 구조를 그대로 살린 카프카 내부 구조
내부 구조를 살피기 전 각각의 명칭을 이해하고 진행하는 편이 좋습니다.
- 프로듀서 (Producer)
: 메시지를 만들어 토픽에 보내는 클라이언트 앱입니다. 카프카 클러스터 바깥에서 동작하고, 메시지의 키에 따라
어느 파티션에 들어갈 지 정해집니다. - 토픽(Topic)
: 메시지를 종류별로 분리하는 논리적 이름입니다(예: orders, payments). 실제 데이터를 담는 물리적 공간이 아니라
파티션을 묶어 부르는 이름입니다. - 파티션(Partition)
: 토픽을 쪼갠 단위로, 메시지가 뒤에 계속 이어 붙는 큐(append-only 로그)입니다. 각 메시지에 offset이 붙고
브로커 디스크에 저장되며, 병렬 처리의 단위가 됩니다. 순서는 파티션 안에서만 보장됩니다. - 컨슈머(Consumer)
: 토픽을 구독해 파티션에서 메시지를 가져가(pull) 처리하는 클라이언트 앱입니다. 컨슈머 그룹으로 묶어 파티션을
나눠 읽고, 자신이 어디까지 읽었는지(offset) 기억 합니다.
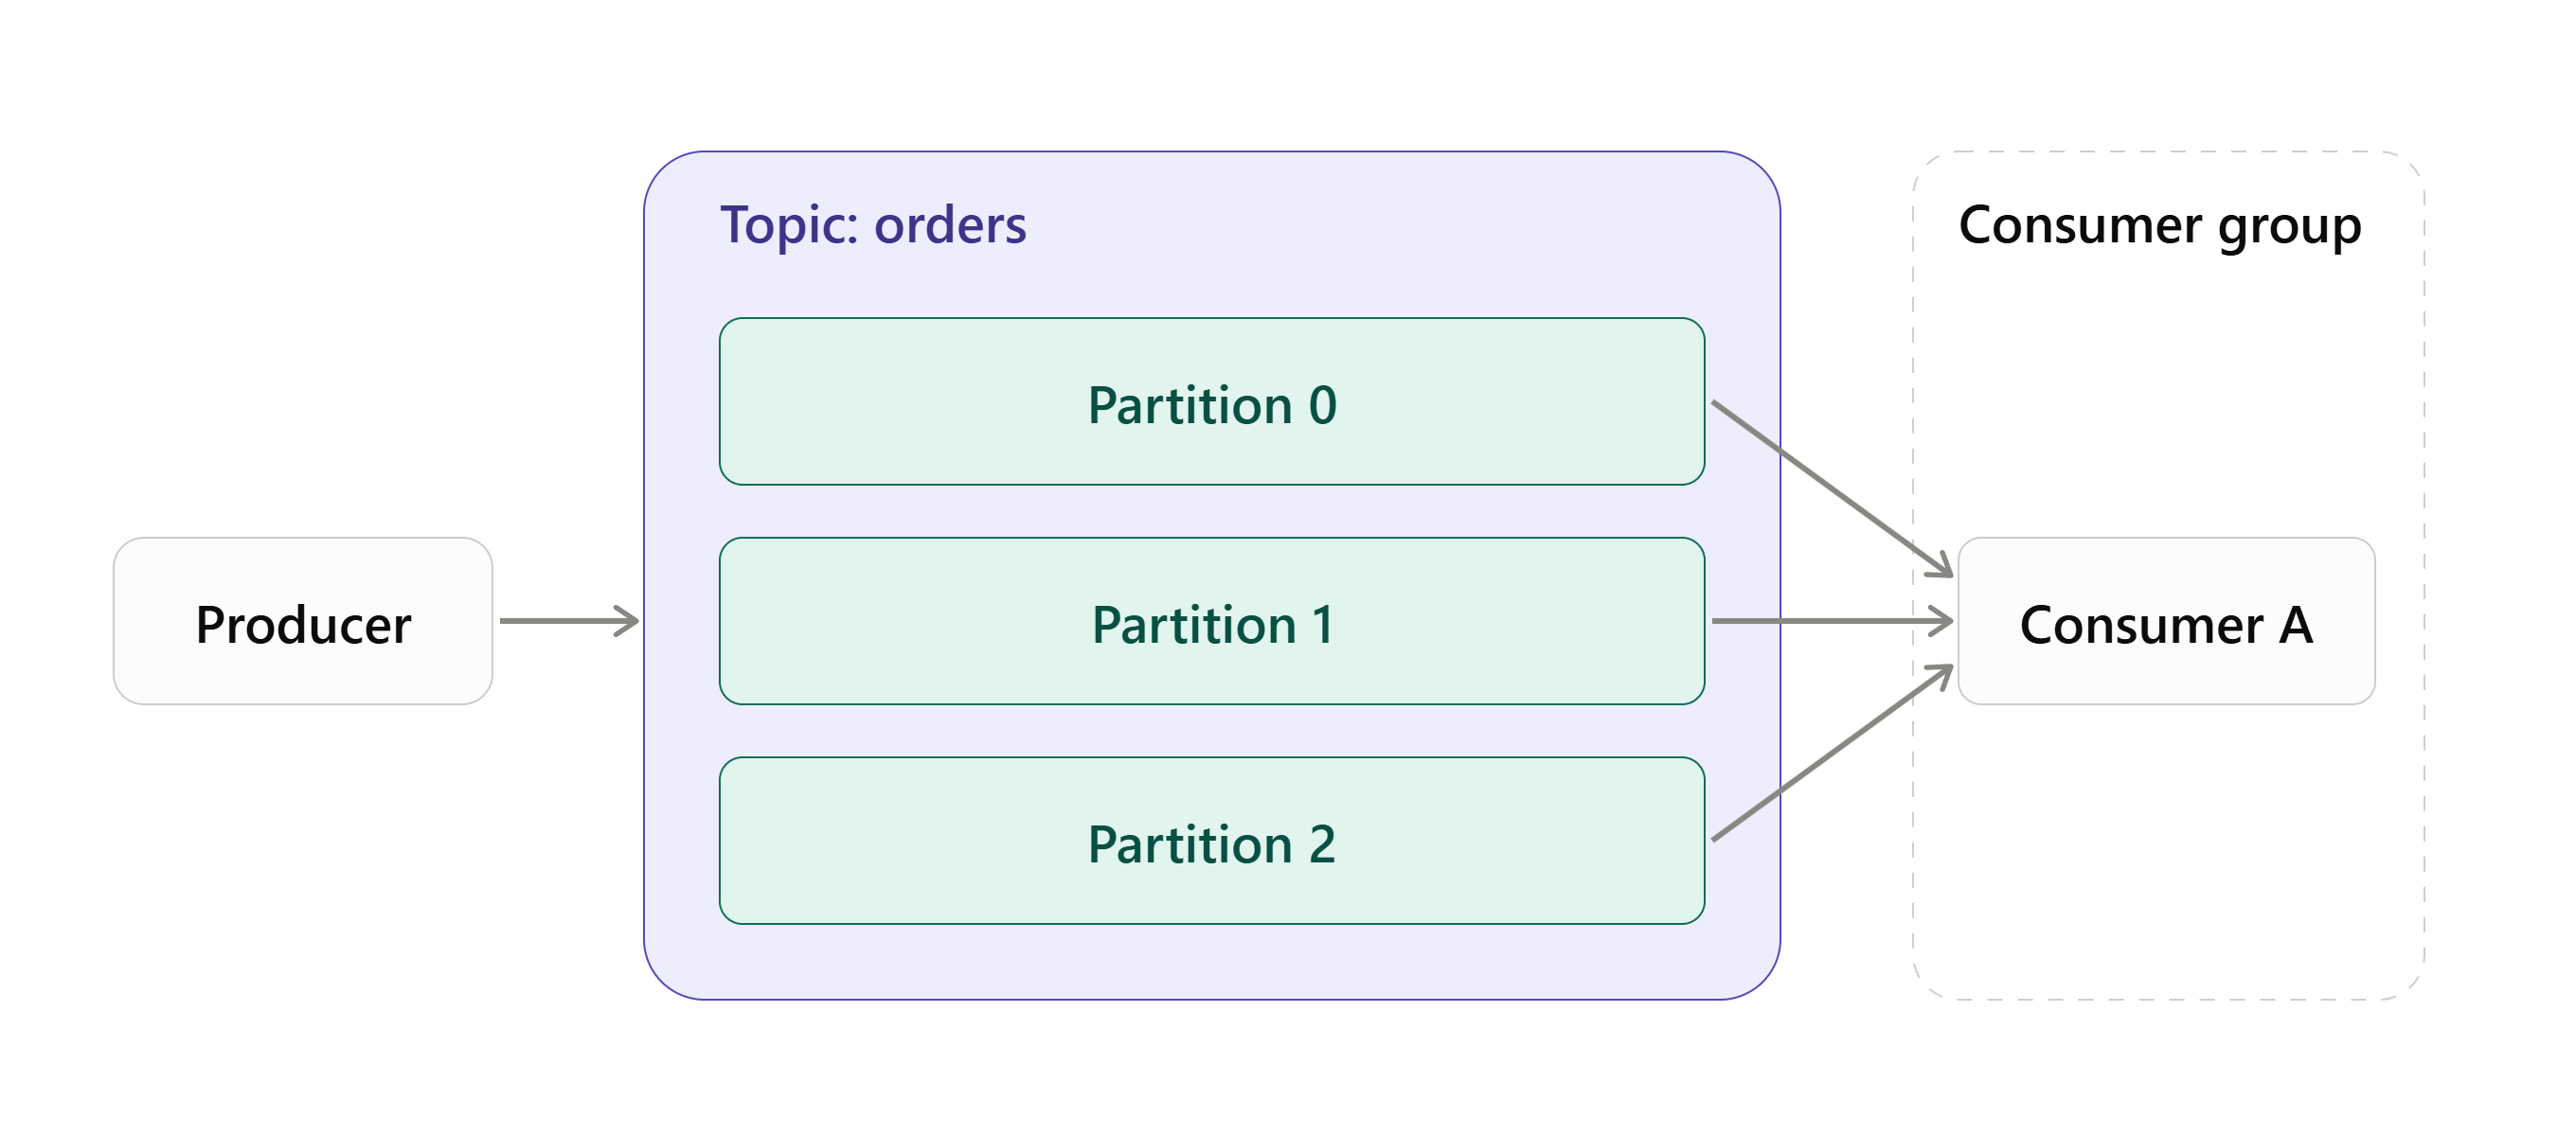
메시지 큐 기본 구조를 그대로 살린 부분은 Producer → Topic → Consumer 흐름입니다. 보내는 쪽과 받는 쪽이 서로를 모르고
중간의 토픽이 둘을 분리해 줍니다.
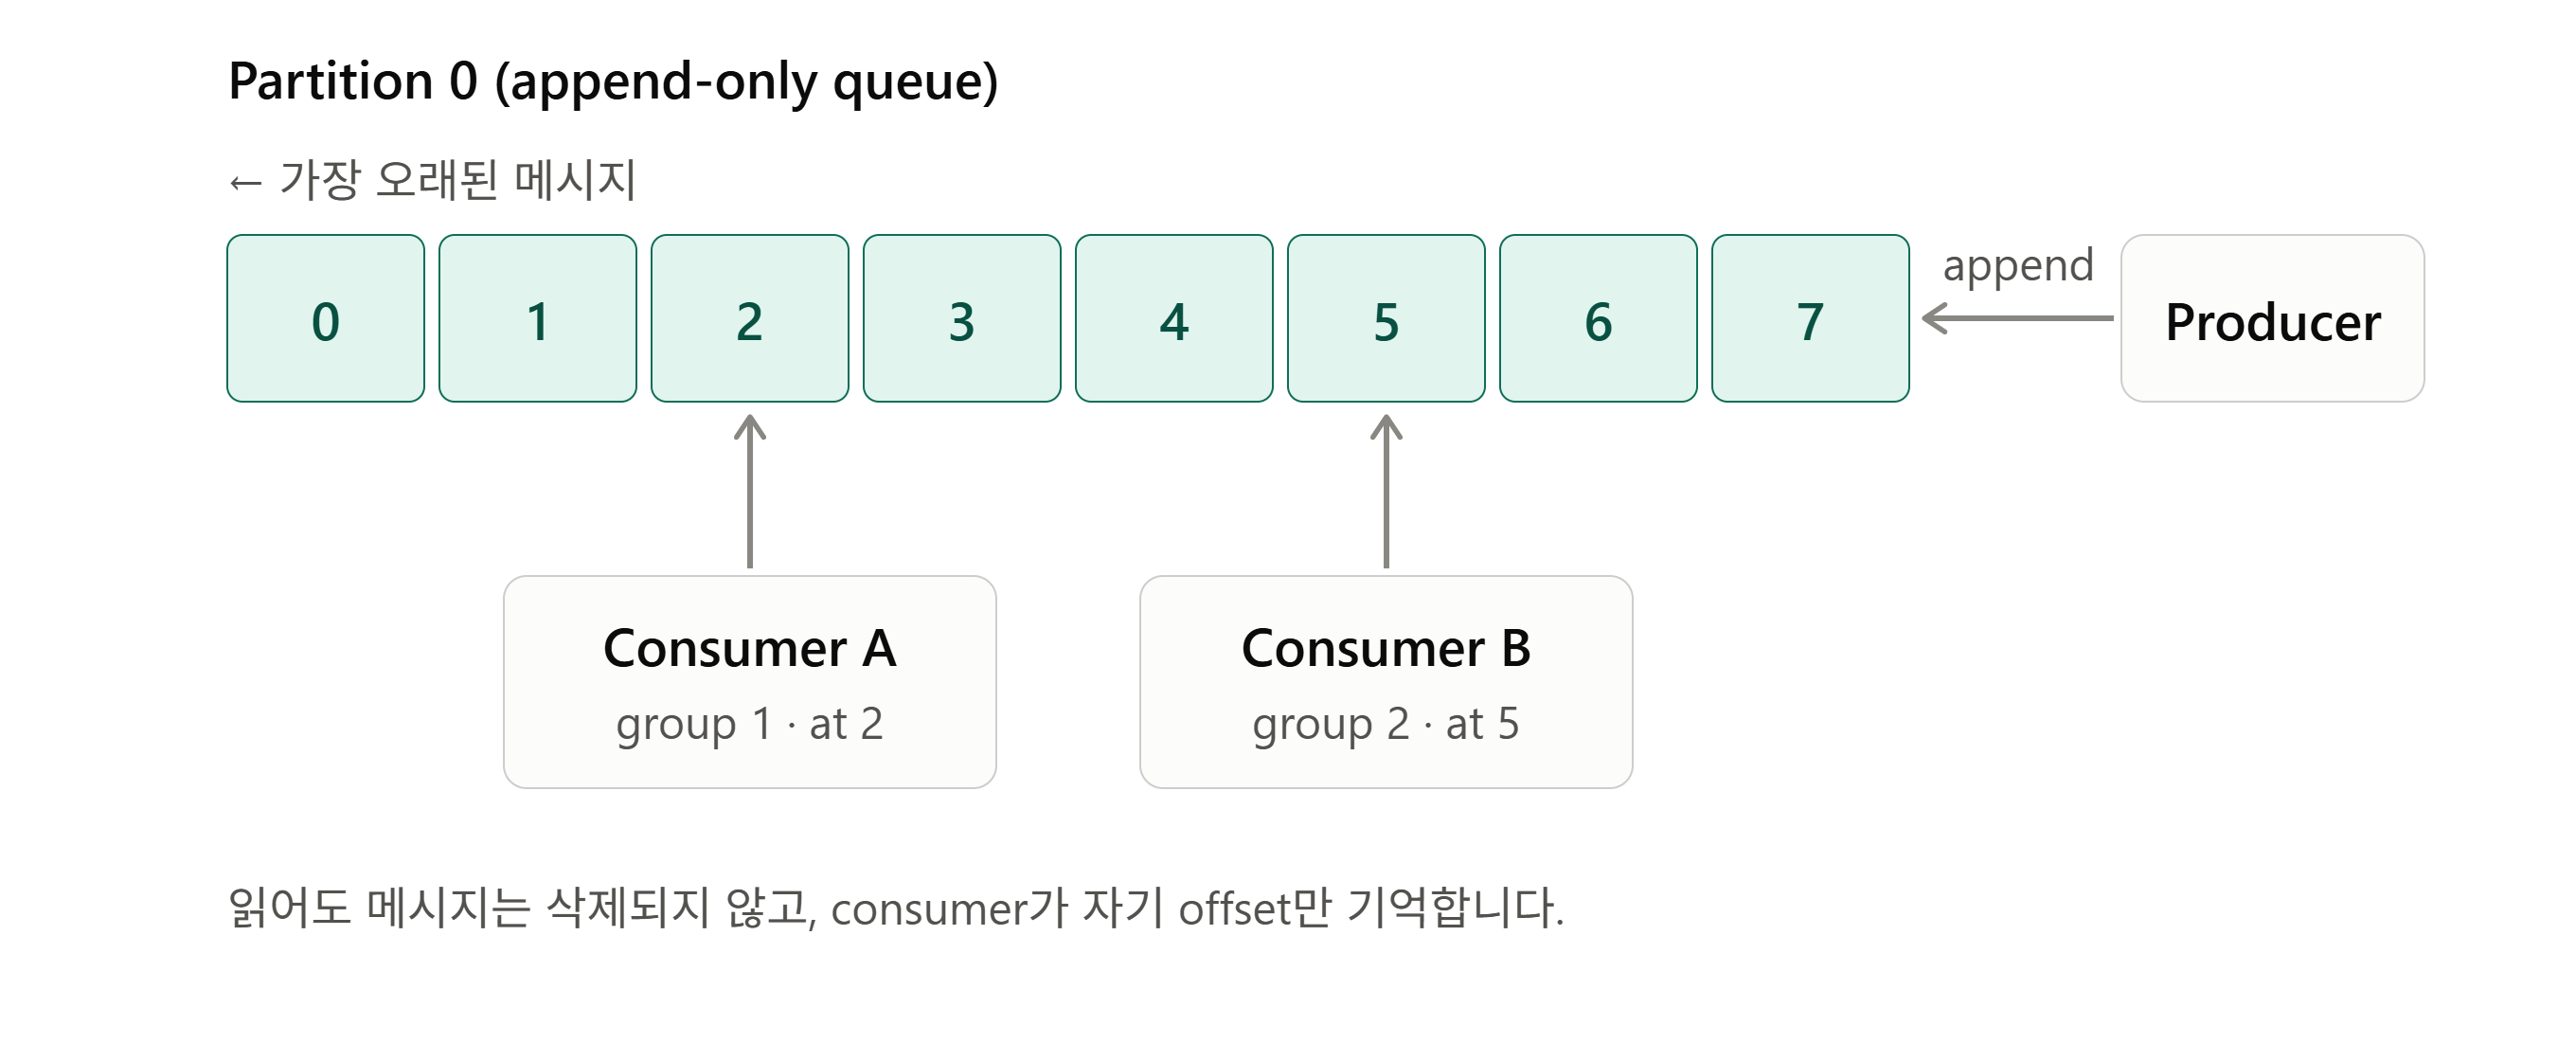
메시지는 파티션의 맨 뒤에 추가되고, 컨슈머는 앞에서부터 순서대로 읽습니다. 큐의 FIFO 성격이 이 파티션 안에서 유지됩니다.
여기서 일반 큐와 달라진 부분이 있습니다.
- 토픽을 여러 파티션으로 쪼갠 것이 핵심입니다. 큐가 여러 개로 나뉘어 있어서 여러 브로커에 분산 저장하고 병렬로 처리할 수 있습니다.
- 컨슈머 그룹이 파티션을 나눠 읽습니다. 같은 그룹 안에서는 파티션 하나를 컨슈머 하나만 읽고, 컨슈머가 1개가 파티션 여러 개를 맡는 것도 가능합니다.
- 읽어도 메시지가 삭제되지 않습니다. 컨슈머가 자기 offset만 기억하기 때문에 다른 그룹이 같은 데이터를 따로 읽거나, offset을 되돌려 재처리할 수 있습니다.
카프카가 데이터 파이프라인으로 적합한 4가지이유
1. 높은 처리량
- 메시지를 디스크에 순차적으로 기록하고(append-only), 배치 전송과 압축을 활용합니다.
- 파티션 단위로 병렬 읽기쓰기가 가능해서, 디스크 기반인데도 대량의 메시지를 빠르게 처리합니다.
2. 확장성(스케일 아웃/ 스케일 인 )
- 데이터량이나 사용자가 늘어도 서버를 추가하는 방식(스케일 아웃)으로 성능을 함께 키울 수 있는 것을 의미합니다.
- 스케일 아웃 : 브로커를 추가해 클러스터를 키우고, 파티션을 늘려 부하를 분산합니다. 컨슈머도 파티션 수 범위 안에서 늘리면 처리 속도가 함께 올라갑니다.
- 스케일 인 : 브로커를 줄일 때는 그 브로커의 파티션을 다른 브로커로 먼저 옮긴(재배치) 뒤 제거 합니다. 컨슈머는 줄이면 남은 컨슈머가 파티션을 다시 나눠 맡습니다(리밸런싱).
- 주의점 : 브로커를 추가해도 기존 파티션이 자동으로 옮겨지지는 않아서, 파티션 재배치 작업이 따로 필요합니다. 파티션 수는 늘릴 수만 있고 줄일 수 없습니다.
- 프로듀서와 컨슈머가 분리되어 있어 각자 독립적으로 확장됩니다.
3. 영속성(파일시스템 기반)
- 데이터를 메모리에만 두지 않고 디스크에 저장해서, 장애나 재시작 후에도 데이터가 남아 있고 다시 읽을 수 있는 성질을 말합니다.
- 카프카는 별도 DB없이 파일시스템에 로그 파일(세그먼트)로 직접 저장합니다. 파티션 하나가 디렉터리이고, 그 안에 세그먼트 파일과 offset인덱스 파일이 쌓이는구조입니다.
- 위에 말한 세그먼트(Segment)란 파티션 로그를 일정 크기로 잘라 저장한 파일 조각을 말합니다.
- 순차 쓰기와 OS 페이지 캐시, zero-copy 전송 덕분에 파일 기반인데도 빠릅니다.
- 메시지는 읽어도 지워지지 않고, 보관 기간(retention)이나 용량 기준에 따라 오래된 세그먼트 단위로 삭제됩니다.
- 그래서 컨슈머가 장애로 멈췄다 돌아와도 자기 offset부터 이어 읽거나, offset을 되돌려 재처리 할 수 있습니다.
4. 고가용성(리플리케이션 / 온프레미스 / 퍼블릭 클라우드)
- 서버나 네트워크 일부에 장애가 나도 서비스가 멈추지 않고 계속 동작하며 데이터도 잃지 않는 성질이며 "브로커 한대가 죽어도 프로듀서는 계속 쓰고, 컨슈머는 계속 읽을 수 있다"는 뜻입니다.
- 리플리케이션
: 파티션마다 복제본(리더1+팔로워N)을 서로 다른 브로커에 둡니다. 리더 브로커가 죽으면 동기화된 팔로워(ISR) 중
하나가 새 리더로 승격돼 서비스와 데이터가 유지됩니다. - 온프레미스
: 복제본이 같은 랙이나 서버에 몰리지 않도록 랙 단위로 분산(rack awareness)하고, 서버·전원 ·네트워크 장애를
직접 대비해야 합니다. 브로커 운영, 업그레이드, 모니터링도 직접 책임 집니다. - 퍼블릭 클라우드
: 브로커를 여 러 가용 영역(AZ)에 나눠 배치해 AZ 하나가 장애가 나도 버틸 수 있습니다. MSK, Confluent Cloud 같은
관리형 서비스를 쓰면 장애 복구와 패치를 클라우드 쪽에서 맡아 줍니다. - 재해 복구(DR)
: 리전이나 데이터센터가 통째로 장애가 나는 경우에 대비해, 클러스터 간 복제 도구(MirrorMaker2 등)로 다른 클러스터에
데이터를 복제해 두기도 합니다. 온프레미스와 클라우드를 섞은 하이브리드 구성에도 쓰입니다.